base de données
PRIMARY KEY + SEQUENCE, FOREIGN KEY + CASCADE) et 2) la chaîne active à 5 maillons (DAO Java → SQL → TRIGGER → STORED PROC → Audit NEW/OLD).
PostgreSQL : deux niveaux de garanties
🔑 Niveau I : Intégrité déclarative (Contraintes DDL)
On déclare la règle une seule fois sur la table avec CREATE TABLE ou ALTER TABLE :
- Clé primaire (
PRIMARY KEY) +SEQUENCE: identifiant unique auto-incrémenté par le serveur. - Clé étrangère (
FOREIGN KEY) : empêche d'assigner un mouton à un troupeau inexistant.
⚡ Niveau II : Intégrité procédurale (Triggers & Fonctions)
Quand une écriture exige une réaction dynamique (archiver l'ancienne valeur OLD ou la nouvelle NEW dans journal) :
- Un Déclencheur (
TRIGGER) intercepteINSERT,UPDATEouDELETE. - Il exécute automatiquement une fonction stockée PL/pgSQL côté serveur.
PROC
DAO Java → SQL → TRIGGER → STORED PROC → Audit NEW/OLD
PostgreSQL - Contraintes d'intégrité
- Clé primaire : garantit que chaque ligne de
troupeauoumoutonpossède un identifiant unique et non nul. - Clé étrangère : garantit l'intégrité référentielle entre la colonne enfant
mouton.id_troupeauet la clé parentetroupeau.id_troupeau.
serial (ou une séquence explicite associée à la colonne).
⚡ Écriture raccourcie (SERIAL / BIGSERIAL)
En déclarant ADD COLUMN id_mouton serial NOT NULL, PostgreSQL crée automatiquement la séquence en coulisse et lie la valeur par défaut.
🛠️ Mécanisme complet dans pgAdmin 4
Sous le capot, PostgreSQL génère un objet SEQUENCE dédié (mouton_id_mouton_seq) appelé par DEFAULT nextval(...) à chaque INSERT.
Clé primaire 'autoincrement'
ALTER TABLE public.mouton
DROP COLUMN id_mouton;

ALTER TABLE public.mouton
    ADD COLUMN id_mouton serial NOT NULL;

ALTER TABLE public.troupeau DROP COLUMN
id_troupeau;

ALTER TABLE public.troupeau
    ADD COLUMN id_troupeau serial NOT NULL;
Sous le capot : Le type serial crée une SEQUENCE et un DEFAULT nextval(...)
-- 1. Retirer l'ancienne colonne id_mouton mal définie
ALTER TABLE public.mouton DROP COLUMN id_mouton;

-- 2. Créer le générateur de numéros (Séquence atomique)
CREATE SEQUENCE public.mouton_id_mouton_seq
    INCREMENT 1  START 1  MINVALUE 1  MAXVALUE 9223372036854775807  CACHE 1;
ALTER SEQUENCE public.mouton_id_mouton_seq OWNER TO postgres;

-- 3. Recréer la colonne liée à la séquence et déclarer la PRIMARY KEY
ALTER TABLE public.mouton
    ADD COLUMN id_mouton bigint NOT NULL DEFAULT nextval('mouton_id_mouton_seq'::regclass);
ALTER TABLE public.mouton
    ADD CONSTRAINT mouton_pkey PRIMARY KEY (id_mouton);
Clé primaire 'autoincrement'
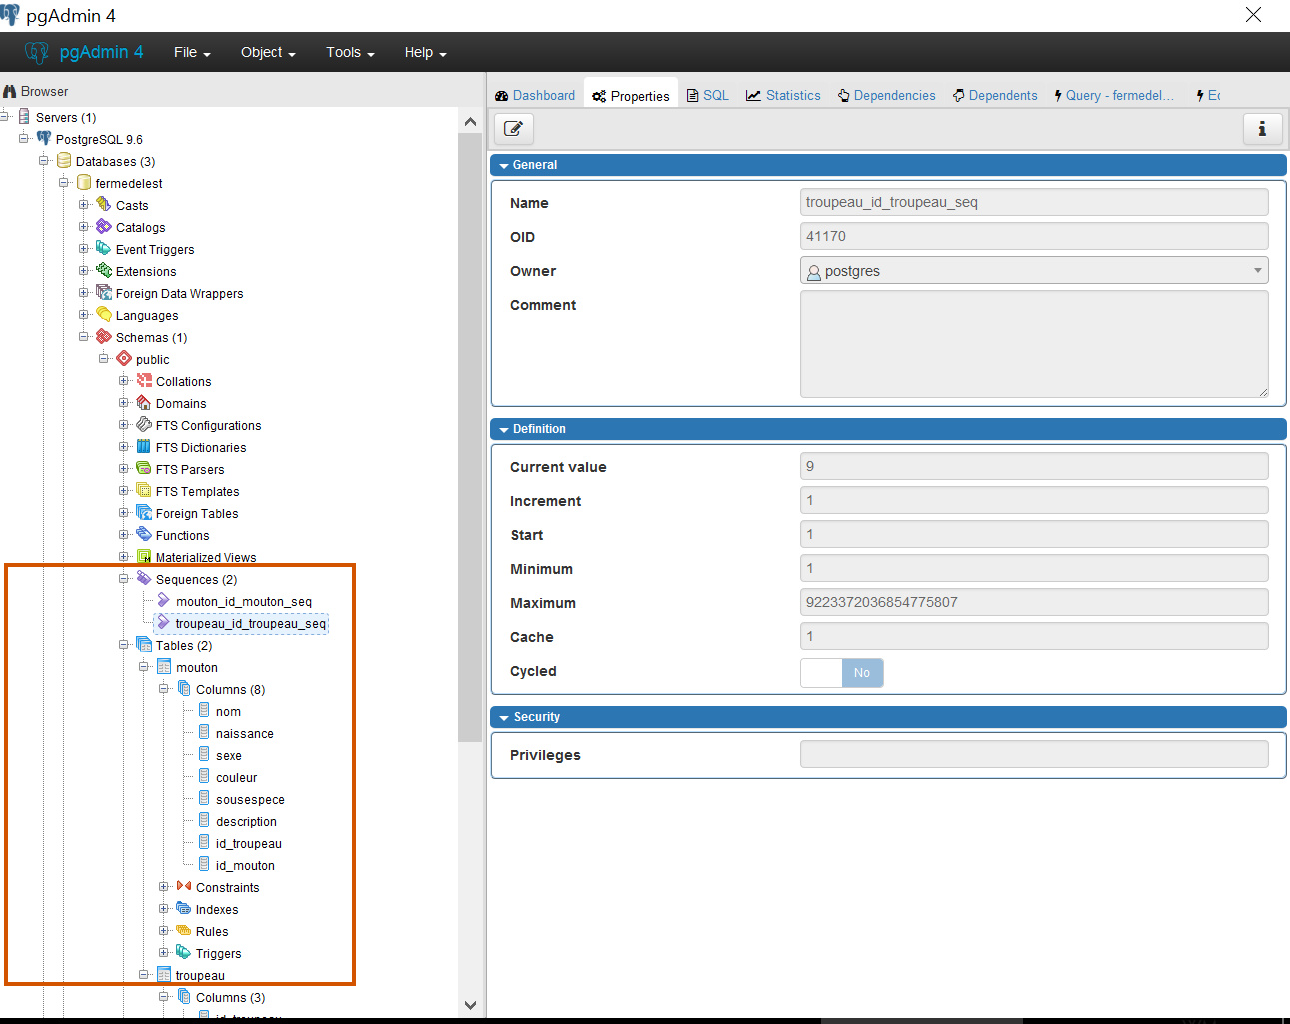
Auto-increment clé primaire
On utilise le type SERIAL ou BIGSERIAL dans la clé primaire.
Clé primaire 'autoincrement'
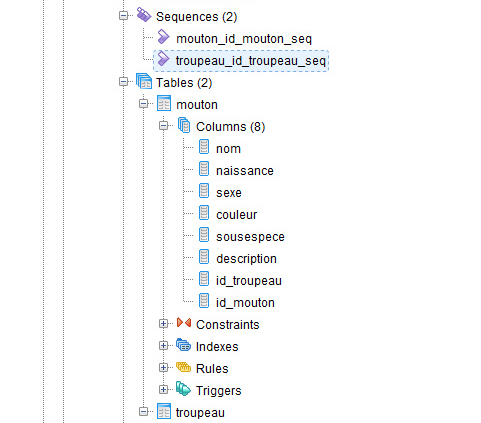
Clé étrangère
- Pour le simple fonctionnement de l'application, la seule condition requise est que la table dépendante (dans un one-to-many) contienne le champs de l'id de son contenant.
- Par exemple la table mouton contient id_troupeau
- La contrainte d'intégrité est pour réenforcer le lien, pour que
- que l'insertion d'un mouton réfère un troupeau existant
- qu'un troupeau référé ne puisse être effacé ou
- pour pouvoir ajouter la cascade de l'effacement
Cependant pour l'insérer les données doivent être intègre : i.e. un mouton ne doit pas référer un troupeau inexistant.
Clé étrangère
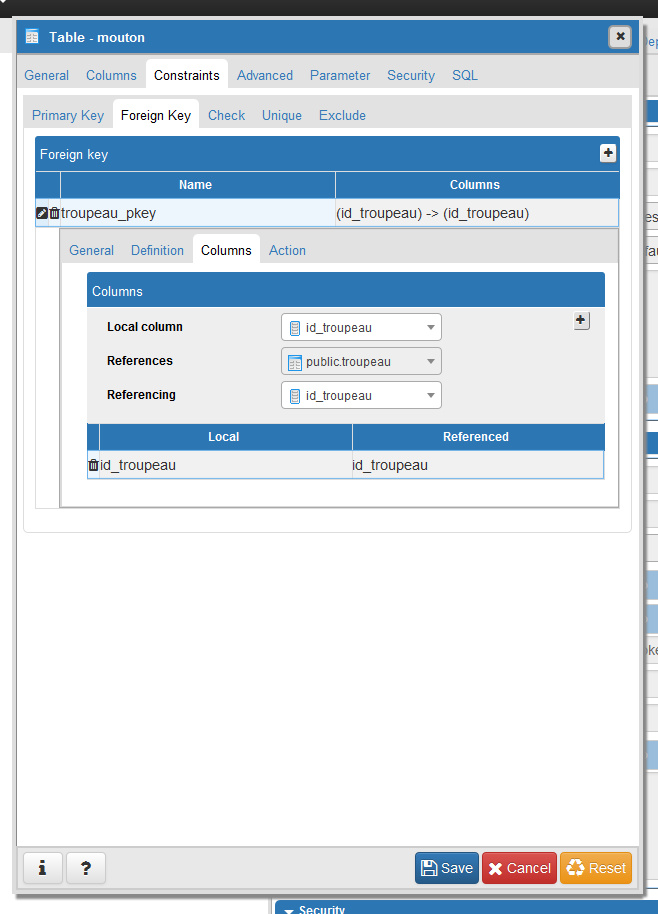
1. Étapes dans pgAdmin 4
- Créer la colonne de référence : une colonne
integerportant le même nom que la colonne de l'autre table (ex. :mouton.id_troupeau). - Créer la clé étrangère :
Table mouton → Constraints → Foreign Key
→+→ Icône Éditer → Remplir les 3 champs (colonne locale, table distante, colonne distante) →+→ Save.
2. Onglet Columns de la Foreign Key
- Local column :
id_troupeau(table enfantmouton). - References :
public.troupeau(table parente). - Referencing :
id_troupeau(clé primaire parente).
Cliquez sur le bouton + en haut à droite du sous-panneau pour valider la paire Local / Referenced.
Clé étrangère
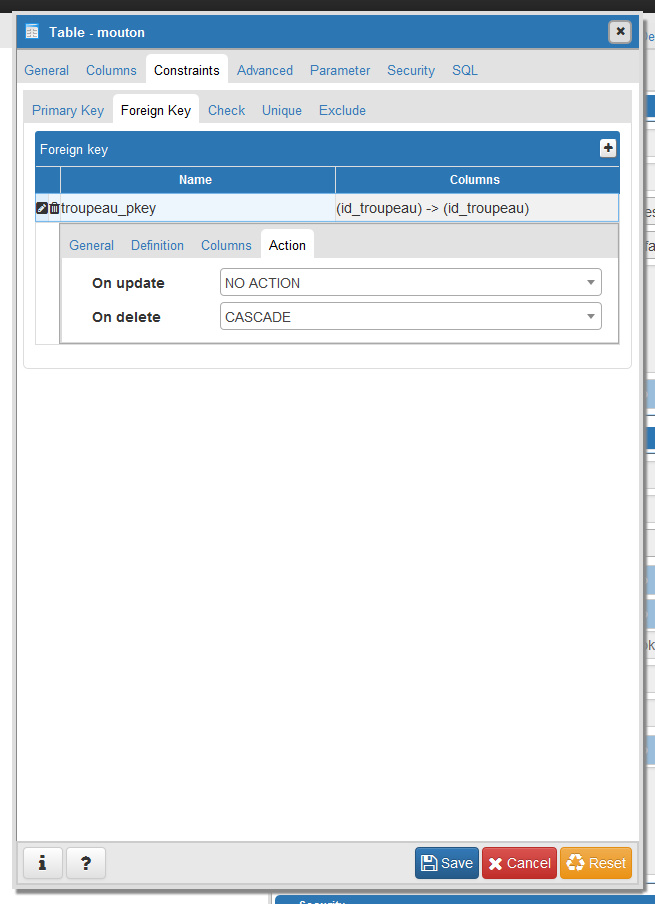
Onglet Action de la Foreign Key
C'est ici que l'assistant génère les clauses :
- On update :
NO ACTION - On delete :
CASCADE(ouRESTRICT/SET NULL).
L'onglet SQL de la boîte de dialogue vous permet de prévisualiser le ALTER TABLE ... ADD CONSTRAINT.
PROC
DAO Java → SQL → TRIGGER → STORED PROC → Audit NEW/OLD
Chaîne d'exécution complète : Étape 1 (DAO)
Maillon ① - Le DAO Java prépare l'opération métier :
L'application cliente (via sa classe MoutonDAO) souhaite ajouter, modifier ou supprimer un mouton. Le DAO n'a aucun besoin de savoir qu'un journal d'audit existe dans la base : il exécute simplement son opération CRUD avec un PreparedStatement.
Rappel DAO
5 fonctions minimum de tout DAO, par exemple dans TrucDAO :
// 1. Les 5 opérations CRUD minimales
List<Truc> listerLesTrucs();
Truc recupererTruc(int id);     // ou lireTruc(int)
void ajouterTruc(Truc truc);
void editerTruc(Truc truc);      // ou modifierTruc(Truc)
void effacerTruc(Truc truc);     // ou supprimerTruc(Truc)

// 2. Dans un contexte one-to-many (DAO de la donnée dépendante)
List<Truc> listerLesTrucsParPatente(Patente patente);

// 3. Selon les besoins, on ajoute des recherches
List<Truc> chercherLesTrucsSelonDate(Date date);
List<Truc> chercherLesTrucsSelonNom(String nom);
List<Truc> chercherLesTrucsSelonCritere(Critere critere); // formulaire avancé
Exemple Collection & Oeuvre
class OeuvreDAO {
  listerLesOeuvres()
  recupererOeuvre(int)
  ajouterOeuvre(Oeuvre)
  editerOeuvre(Oeuvre)
  effacerOeuvre(Oeuvre)
}
class CollectionDAO {
  listerLesCollections()
  recupererCollection(int)
  ajouterCollection(Collection)
  editerCollection(Collection)
  effacerCollection(Collection)
}
// Dans un contexte one-to-many (DAO de la donnée dépendante) :
OeuvreDAO.listerOeuvresParCollection(Collection /* ou int */)

// Selon les besoins, souvent on ajoute des recherches :
OeuvreDAO.chercherLesOeuvresSelonDate(Date)
OeuvreDAO.chercherLesOeuvresSelonTitre(String)
OeuvreDAO.chercherLesOeuvresSelonCritere(Critere)
Chaîne d'exécution complète : Étape 2 (SQL)
Pour un SQL de DAO optimal :
1. Clé primaire
Auto-increment dans la clé primaire (SERIAL / BIGSERIAL)
2. Paramétrage
Requêtes préparées (PreparedStatement)
3. Indexation
Index sur les champs DAO :
- Ordonnés (
ORDER BY) - Cherchés (
WHERE)
Paramétrage : Requête préparée
- Pour se protéger des injections SQL en utilisant le framework de remplacement
- Pour la rapidité d'exécution
- Égale la rapidité d'une procédure stockée mais avec une bien meilleure architecture
- Entraîne la création des index correspondants
- Uniformise les requêtes utilisées par les programmeurs dans une même application
- Pour la maintenance
- Les requêtes SQL pourront être modifiée dans les interfaces ou fichiers xml par les non-programmeurs (DBA par exemple)
String SQL_TROUVER_JOUET =
      "SELECT * FROM jouet WHERE id_jouet = " + jouet.getId();

String recherche = "';UPDATE utilisateur SET\nmotdepasse='machine' WHERE nom = 'jo'";

String SQL_CHERCHER_JOUETS =
      "SELECT * FROM jouet WHERE nom like '%" + recherche + "%'";
Paramétrage : Requête préparée
String SQL_TRUC = "SELECT * FROM truc WHERE machin like ?";
PreparedStatement requeteTruc = connection.prepareStatement(SQL_TRUC);
requeteTruc.setString(1, "%bla");
resultat = requeteTruc.executeQuery();


String SQL_AJOUTER_TRUC = "INSERT INTO truc(nom, masse) values(?, ?)";
PreparedStatement requeteAjouterTruc =
                              connection.prepareStatement(SQL_AJOUTER_TRUC);
requeteAjouterTruc.setString(1, "mimi");
requeteAjouterTruc.setInt(2, 5);
requeteAjouterTruc.executeUpdate();
Requêtes préparées - exemple
String SQL_TROUVER_OEUVRE = "SELECT * FROM oeuvre WHERE id_oeuvre = ?";
PreparedStatement requeteTrouverOeuvre =
connection.prepareStatement(SQL_TROUVER_OEUVRE);
requeteTrouverOeuvre.setInt(1, id_recu);
resultat = requeteTrouverOeuvre.executeQuery();


String SQL_MODIFIER_OEUVRE = "UPDATE oeuvre SET nom = ?, auteur = ?\nWHERE id_oeuvre = ?";
PreparedStatement requeteModifierOeuvre =
                              connection.prepareStatement(SQL_MODIFIER_OEUVRE);
requeteModifierOeuvre.setString(1, oeuvre.getNom());
requeteModifierOeuvre.setString(2, oeuvre.getAuteur());
requeteModifierOeuvre.setInt(3, oeuvre.getId());
requeteModifierOeuvre.executeUpdate();
Requêtes préparées - todo
Statement) pour pouvoir les afficher et les débugger facilement, puis les convertir ensuite en requêtes préparées (PreparedStatement) en suivant les étapes ci-dessous :
CONNECTION
  - changer Statement pour PreparedStatement
  - changer connection.createStatement() pour connection.prepareStatement()

REQUETE
  - Déplacer requête SQL de executeQuery vers prepareStatement()

TEST & BINDING
  - Remplacer les valeurs par des ?
  - Ajouter les requete.setString() et requete.setInt() (avant le execute)
Indexation : observer le DAO pour optimiser la BDD
Règle d'or d'inspection : En observant les constantes SQL au début de nos classes DAO (ex. SELECT * FROM truc WHERE machin LIKE ?), on déduit immédiatement qu'on doit indexer le champ machin pour optimiser sa recherche.
🔍 Quels champs du DAO indexer ?
- Champs cherchés (
WHERE) : colonnes filtrées parchercherSelonNom(),chercherSelonDate(), etc. - Champs ordonnés (
ORDER BY) : colonnes servant au tri d'affichage. - Clés étrangères (
id_troupeau) : pour accélérerlisterMoutonsParTroupeau().
⚡ Deux structures d'accès rapide
Sans index, PostgreSQL parcourt toutes les lignes une par une (O(N)). Un index maintient une structure dédiée pointant vers la rangée :
- 1. Arbre de recherche équilibré : recherche en
log2(N)étapes. - 2. Table de hachage (Hash) : calcul direct de la case sans parcourir.
-- Création d'un index dans PostgreSQL sur le champ filtré par le DAO :
CREATE INDEX idx_truc_machin ON public.truc (machin);
Structure d'index 1/2 : Arbre de recherche équilibré
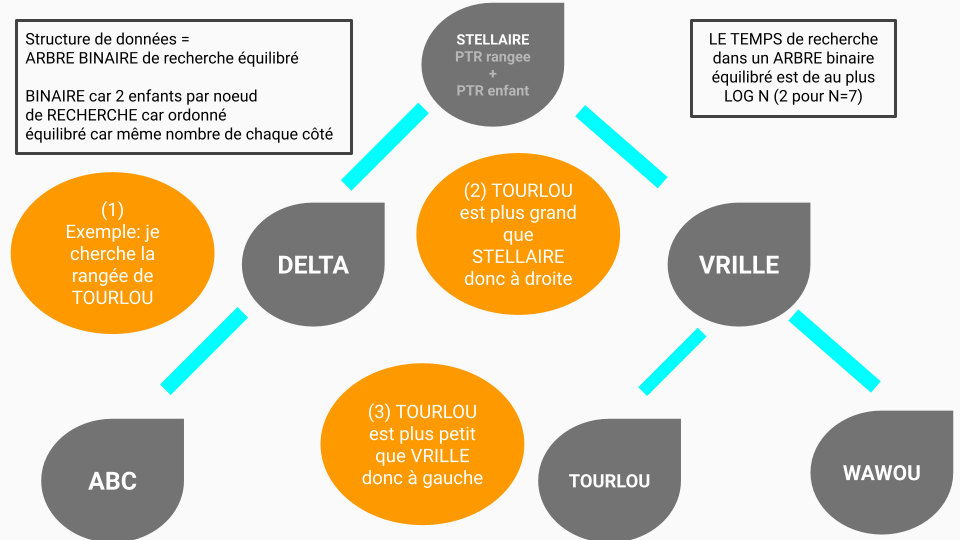
Principe de l'Arbre équilibré
- Chaque nœud stocke la clé, le pointeur de rangée (
PTR rangee) et les pointeurs vers ses enfants. - Ordonné : plus petit à gauche, plus grand à droite.
- Équilibré : même profondeur de chaque côté → au plus
log2(N)comparaisons (ex.2pourN = 7).
Idéal pour quelles requêtes DAO ?
Supporte à la fois l'égalité (=), les intervalles (<, >, BETWEEN), les préfixes et le tri ORDER BY.
Structure d'index 2/2 : Table de hachage (Hash Index)
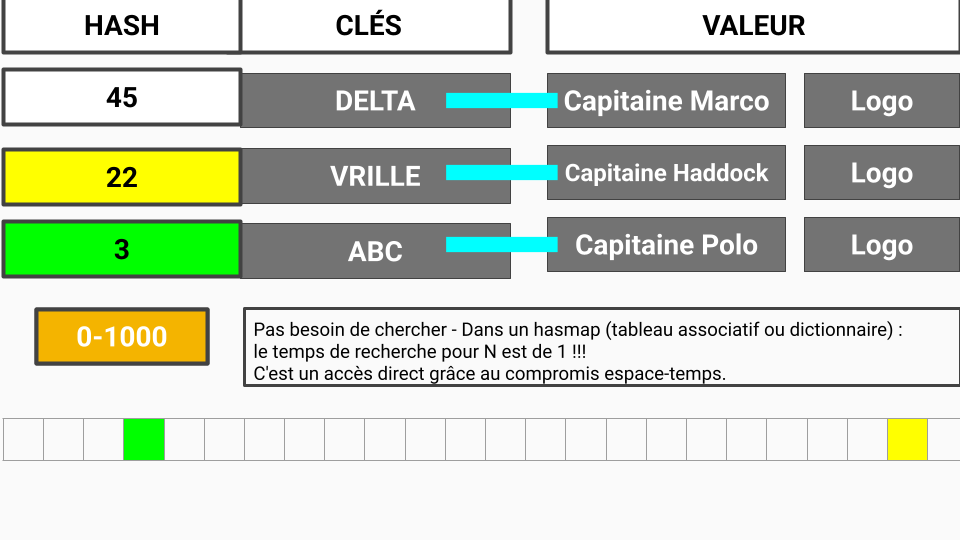
Principe du Hachage (Hash)
- Une fonction transforme la Clé (ex.
DELTA,VRILLE,ABC) en un numéro de case Hash (ex.45,22,3entre0et1000). - Accès direct
O(1): « Pas besoin de chercher », accès direct en temps constant grâce au compromis espace-temps !
Portée & Limite
Ultra-rapide pour une comparaison d'égalité stricte (WHERE cle = ?), mais ne permet pas de trier (ORDER BY) ni de chercher par intervalle (<, >).
Chaîne d'exécution complète : Étape 3 (TRIGGER)
Maillon ③ - PostgreSQL intercepte l'écriture grâce au TRIGGER :
Dès que le PreparedStatement du DAO modifie la table mouton, PostgreSQL active le déclencheur attaché à la table. En PostgreSQL, on distingue deux objets : 1) la fonction trigger (qui contient le code PL/pgSQL) et 2) le déclencheur CREATE TRIGGER (qui branche cette fonction sur la table).
SQL - Suite · Les 3 écritures qui déclencheront nos Triggers
// 1. INSERT (déclenchera le trigger d'ajout)
String SQL_AJOUTER_MOUTON = "INSERT into mouton(nom, couleur, naissance, sousespece, description, id_troupeau, sexe) VALUES(?, ?, ?, ?, ?, ?, ?)";
PreparedStatement requeteAjouterMouton = connexion.prepareStatement(SQL_AJOUTER_MOUTON);

// 2. UPDATE (déclenchera le trigger de modification)
String SQL_MODIFIER_MOUTON = "UPDATE mouton SET nom = ?, couleur = ?, naissance = ?, sousespece = ?, description = ?, sexe = ? WHERE id_mouton = ?";
PreparedStatement requeteModifierMouton = connexion.prepareStatement(SQL_MODIFIER_MOUTON);

// 3. DELETE (déclenchera le trigger de suppression)
String SQL_EFFACER_MOUTON = "DELETE FROM mouton WHERE id_mouton = ?";
PreparedStatement requeteEffacerMouton = connexion.prepareStatement(SQL_EFFACER_MOUTON);
INSERT : On ne fournit pas id_mouton dans la liste des colonnes, car notre séquence mouton_id_mouton_seq s'en charge automatiquement.
PostgreSQL - Déclencheurs - Syntaxe officielle
CREATE [ CONSTRAINT ] TRIGGER name { BEFORE | AFTER | INSTEAD OF } { event [ OR ... ] }
    ON table_name
    [ FROM referenced_table_name ]
    [ NOT DEFERRABLE | [ DEFERRABLE ] [ INITIALLY IMMEDIATE | INITIALLY DEFERRED ] ]
    [ FOR [ EACH ] { ROW | STATEMENT } ]
    [ WHEN ( condition ) ]
    EXECUTE PROCEDURE function_name ( arguments )

where event can be one of:  INSERT  |  UPDATE [ OF column_name [, ... ] ]  |  DELETE  |  TRUNCATE
EXECUTE FUNCTION nom_fonction() et EXECUTE PROCEDURE nom_fonction() sont tous deux acceptés dans CREATE TRIGGER.
Décryptage des 6 clauses de CREATE TRIGGER
CREATE TRIGGER name { BEFORE | AFTER | INSTEAD OF } { event [ OR ... ] }
    ON table_name
    [ FOR [ EACH ] { ROW | STATEMENT } ]
    EXECUTE PROCEDURE function_name ( arguments )
where event can be one of:  INSERT  |  UPDATE [ OF column_name ]  |  DELETE
Questions 1 à 3 : Quand, Où, Quoi ?
- 1.
BEFORE | AFTER: Avant ou après l'écriture ? - 2.
ON table_name: Sur quelle table (public.mouton) ? - 3.
INSERT | UPDATE | DELETE: Sur quelles opérations ?
Questions 4 et 5 : Granularité et Fonction
- 4.
FOR EACH ROW | STATEMENT: Par ligne (ROW) ou par requête (STATEMENT) ? - 5.
EXECUTE PROCEDURE: Quelle fonction trigger appeler ?
PostgreSQL - Déclencheurs - Exemple sur mouton
CREATE TRIGGER "journalMoutons"
    BEFORE INSERT OR DELETE OR UPDATE
    ON public.mouton
    FOR EACH STATEMENT
    EXECUTE PROCEDURE public.journaliser();
journalMoutons écoute les ajouts, suppressions et modifications sur public.mouton, et appelle la fonction public.journaliser().
Chaîne d'exécution complète : Étape 4 (STORED PROC)
Maillon ④ - Le Trigger invoque la procédure/fonction stockée (STORED PROC) :
Observons dans pgAdmin 4 comment un déclencheur est rattaché à la table mouton, puis comment programmer une fonction SQL et une fonction trigger en PL/pgSQL.
I/O des procédures stockées
| Procédure stockée | Fonction |
|---|---|
| - | Utilisable dans expression |
| Retourne une valeur externe |
Retourne une valeur |
| Retourne une ou plusieurs tables de résultats |
Retourne une table de résultats |
Note: Même si la procédure stockée a la capacité de retourner des valeurs,
en général c'est la fonction qui est utilisée pour cela, car elle est nommée
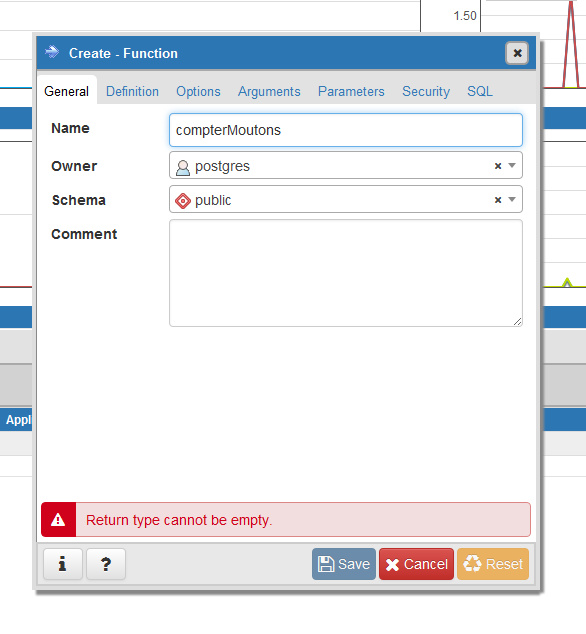
Créer la fonction
1. Créer la fonction dans pgAdmin 4
SCHEMAS/PUBLIC/FUNCTIONS
(clic droit -> Create)
- Le nom des fonctions commence par un verbe !
- Si le type de retour choisi est incorrect, un avertissement empêche l'enregistrement dans pgAdmin.
2. Arborescence pgAdmin 4 (Triggers)
Chaque table possède son sous-dossier Triggers :
mouton → Triggers → journalMoutons- L'onglet Properties affiche la fonction cible (
journaliser) et les événements actifs (INSERT,UPDATE,DELETE).
Test & correction
- Ouvrir le Query Tool (Clic droit sur
Schemas > Query Tool) - Taper et cliquer sur l'éclair pour exécuter :
SELECT nomDeFonction();
- Clic droit sur la fonction →
Scripts > CREATE Script - Corriger :
- Effacer
Rows 0, - Effacer les guillemets alentour du nom de fonction
- Exécuter l'éclair
- Effacer
Créer la fonction
Où trouver vos fonctions dans pgAdmin 4 ?
- Les fonctions qui retournent un type standard (
bigint,text) sont sousFunctions. - Les fonctions déclarées avec
RETURNS triggersont sousTrigger Functions.
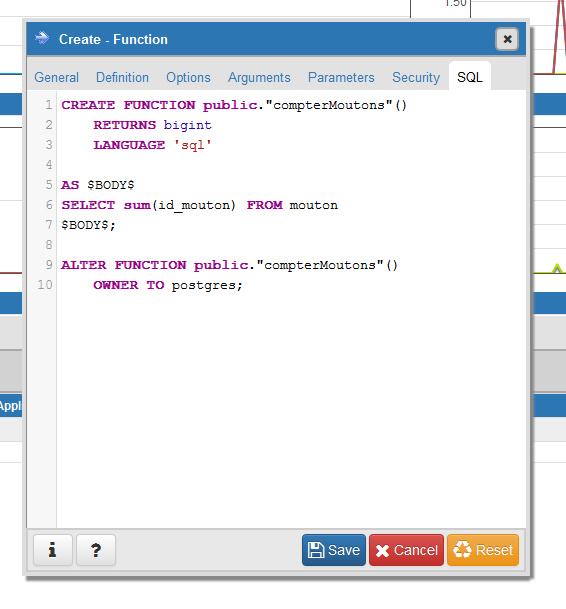
Assistant graphique vs SQL généré
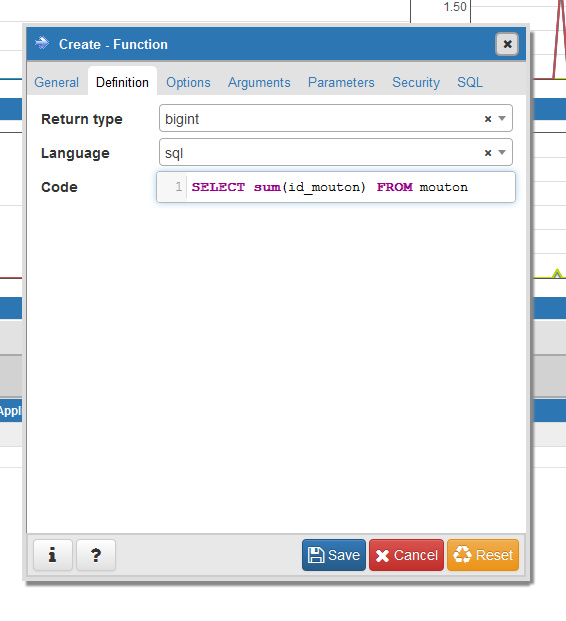
Dans pgAdmin 4 : clic droit sur Functions → Create → Function...
Astuce d'inspection : Remarquez à la ligne 6 SELECT sum(id_mouton) (qui additionnerait les IDs) au lieu de SELECT count(id_mouton). Toujours relire l'onglet SQL avant de sauvegarder !
Créer la fonction
PostgreSQL - Procédure stockée (Fonction SQL)
CREATE FUNCTION public."compterMoutons"()
    RETURNS bigint
    LANGUAGE 'sql'
AS $BODY$
    SELECT count(id_mouton) FROM mouton
$BODY$;

ALTER FUNCTION public."compterMoutons"() OWNER TO postgres;
$BODY$ ... $BODY$ entourent le corps de la fonction pour permettre l'usage d'apostrophes simples sans avoir à les doubler.
PostgreSQL - Procédure stockée (CREATE OR REPLACE)
CREATE OR REPLACE FUNCTION public."compterMoutons"()
    RETURNS bigint  LANGUAGE 'sql'  COST 100  VOLATILE
AS $BODY$
    SELECT count(id_mouton) FROM mouton
$BODY$;

ALTER FUNCTION public."compterMoutons"() OWNER TO postgres;
Pourquoi CREATE OR REPLACE ?
Met à jour le corps d'une fonction existante sans DROP FUNCTION (préserve les triggers qui en dépendent).
Que signifie VOLATILE ?
Indique que le résultat peut changer d'un appel à l'autre (car la table mouton évolue).
Étape 1 : Nom et schéma (Onglet General)
- Name :
compterMoutons - Owner :
postgres· Schema :public
Le bandeau Return type cannot be empty disparaît dès que vous remplissez l'onglet suivant (Definition).
Étape 2 : Type de retour, langage et code (Onglet Definition)
- Return type :
bigint(fonction classique) outrigger(fonction appelée par un déclencheur). - Language :
sqlouplpgsql(dès qu'on utiliseBEGIN ... END;ouNEW/OLD).
Créer la fonction
PostgreSQL - Procédure stockée en plpgsql
CREATE OR REPLACE FUNCTION public.compterMoutons()
    RETURNS bigint  LANGUAGE 'plpgsql'  COST 100  VOLATILE
AS $BODY$
DECLARE
    total bigint;
BEGIN
    SELECT count(id_mouton) INTO total FROM mouton;
    RETURN total;
END;
$BODY$;
LANGUAGE 'sql' vs LANGUAGE 'plpgsql' : Le langage procédural plpgsql ajoute le bloc DECLARE ... BEGIN ... END;, les variables locales (SELECT ... INTO), les conditions (IF) et la gestion des triggers (RETURNS trigger avec NEW / OLD).
Chaîne d'exécution complète : Étape 5 (SQL d'audit)
Maillon ⑤ - La procédure stockée exécute à son tour du SQL (INSERT INTO journal) :
C'est la fermeture de la boucle : une seule requête envoyée par le DAO Java a déclenché en cascade le Trigger, puis la fonction stockée, qui exécute elle-même une requête d'écriture dans la table journal.
Journalisation dynamique avec NEW et OLD
FOR EACH ROW
-- Enveloppe de la fonction Trigger (en plpgsql) qui contient le SQL d'audit ci-dessous :
CREATE OR REPLACE FUNCTION public.journaliser() RETURNS trigger LANGUAGE 'plpgsql' AS $BODY$
BEGIN  /* ... requête SQL d'insertion dans journal (voir les 3 cas ci-dessous) ... */  RETURN NEW; END $BODY$;
-- 1. Sur INSERT : NEW contient la nouvelle ligne insérée
INSERT INTO journal(moment, description) VALUES(NOW(), 'Ajout : ' || NEW.nom || ' (' || NEW.naissance || ')');

-- 2. Sur UPDATE : OLD contient l'état avant modification, NEW contient l'état après
INSERT INTO journal(moment, description) VALUES(NOW(), OLD.nom || ' -> ' || NEW.nom || ' , ' || OLD.couleur || ' -> ' || NEW.couleur);

-- 3. Sur DELETE : OLD contient la ligne qui vient d'être supprimée
INSERT INTO journal(moment, description) VALUES(NOW(), 'Suppression #' || OLD.id_mouton || ' (' || OLD.nom || ')');
Disponibilité de NEW et OLD (FOR EACH ROW)
• INSERT : NEW défini, OLD absent.
• UPDATE : OLD et NEW définis.
• DELETE : OLD défini, NEW absent.
Valeur de retour obligatoire
En BEFORE ... FOR EACH ROW, terminez par RETURN NEW; (INSERT/UPDATE) ou RETURN OLD; (DELETE).